Meer kwetsbaarheden, minder handmatig onderhoud: waarom geautomatiseerde pipelines essentieel zijn
Meer kwetsbaarheden vragen om geautomatiseerd lifecycle management. HIT combineert zinvolle tests, canary releases en monitoring om productierisico’s te beperken.
Er komt een beveiligingsupdate beschikbaar voor een softwarebibliotheek die je applicatie gebruikt. Het toepassen ervan kan in enkele minuten gebeuren. Uitzoeken of het de authenticatie, een klantworkflow of een integratie verstoort kan veel langer duren.
Wanneer elke update handmatig onderzoek en een zorgvuldig gecoördineerde avond voor de uitrol vereist, wordt onderhoud een wachtrij. Hoe langer die wachtrij wordt, hoe langer systemen mogelijk kwetsbaar blijven.
Bij HIT is ons standpunt duidelijk: geautomatiseerde pipelines zijn nu essentieel om productiesoftware in een vol te houden tempo te onderhouden. Hun waarde hangt af van het bewijs dat ze leveren: zinvolle tests vóór de release, een gecontroleerde uitrol tijdens de uitrol en monitoring die een slechte wijziging kan stoppen.
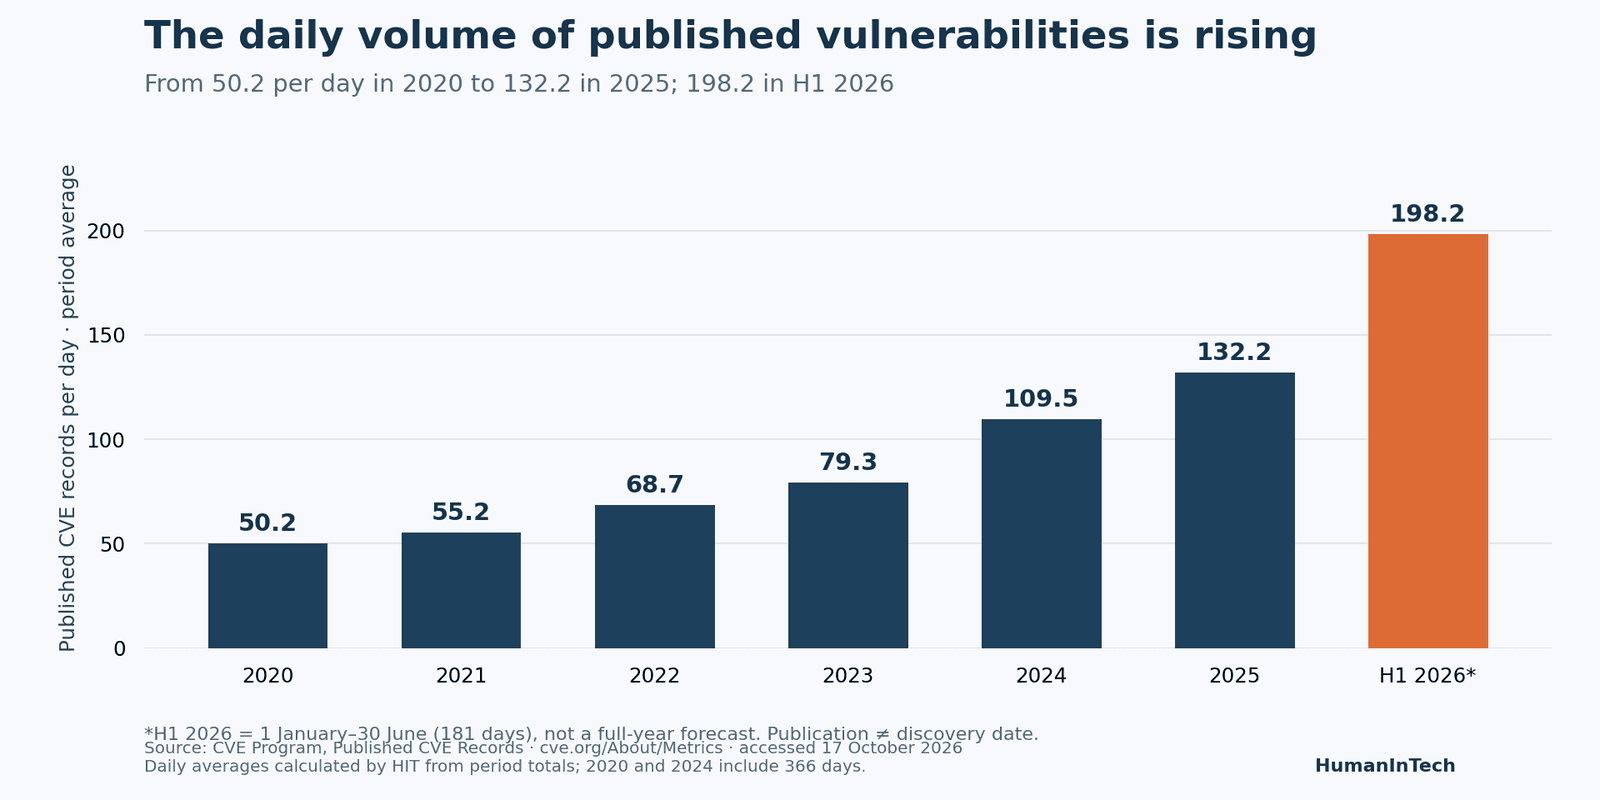
Van ongeveer 50 gepubliceerde kwetsbaarheden per dag naar bijna 200
Het CVE Program registreerde 18.375 gepubliceerde CVE-records in 2020: gemiddeld 50,2 per dag. In 2025 bereikte dat 48.244, of 132,2 per dag. Voor januari–juni 2026 vermeldt het 35.872 records: 198,2 per dag over 181 dagen. Dit zijn HIT-berekeningen op basis van de officiële CVE-publicatiestatistieken, geraadpleegd op 17 oktober 2026.
De grafiek gebruikt periodetotalen gedeeld door kalenderdagen, inclusief schrikkeljaren. De balk voor 2026 dekt alleen de eerste helft van het jaar, het is geen prognose voor het hele jaar. Bij raadpleging waren de cijfers voor het derde kwartaal nog niet beschikbaar.
Deze cijfers tellen gepubliceerde records, niet kwetsbaarheden die op elke dag ontdekt zijn, aanvallen of fouten die jouw specifieke applicatie raken. Veranderingen in rapportagedekking en publicatiepraktijken beïnvloeden ook de totalen. De cijfers wijzen dus op meer meldingen die beoordeeld moeten worden. Ze meten niet rechtstreeks het risico voor jouw organisatie.
Lifecycle management heeft een herhaalbaar pad naar productie nodig
Lifecycle management, of LCM, omvat het up-to-date houden van dependencies, runtimes, container images en besturingssystemen op ondersteunde versies. Het betekent ook het plannen van upgrades voordat componenten het einde van de ondersteuning bereiken.
We willen dat routinematig, goed begrepen onderhoud via een grotendeels geautomatiseerd proces verloopt. Een geplande controle identificeert een update, stelt een kleine wijziging voor, bouwt een release met een vast versienummer en voert de vereiste controles uit. In aanmerking komende wijzigingen kunnen dan volgens een afgesproken beleid verder gaan. Upgrades met incompatibele wijzigingen, destructieve migraties en onzekere resultaten gaan naar een specialist voor beoordeling.
Een patch voor een HTTP-bibliotheek zou bijvoorbeeld meer in gang moeten zetten dan een succesvolle build. De pipeline moet login, uitgaande API-calls, timeouts en foutafhandeling verifiëren voordat de release verder mag gaan.
Automatisering moet ook helpen beslissen wat eerst aandacht nodig heeft. We raden aan om een inventaris van de gebruikte componenten, de daadwerkelijke blootstelling, leveranciersadviezen en bewijs van actief misbruik te combineren. De update van NIST in april 2026 illustreert deze behoefte aan prioritering: de NVD geeft nu prioriteit aan verrijking van geselecteerde CVE's, inclusief die in de Known Exploited Vulnerabilities catalog van CISA. Een ontbrekende NVD-analyse is geen bewijs dat een kwetsbaarheid onschadelijk is. Bron: NIST over de aangepaste werking van de NVD.
Sanity tests zijn de minimale basis
Een pipeline die succesvol bouwt vertelt ons dat de software gebouwd kan worden. Dat vertelt ons nog niet of klanten de toepassing kunnen blijven gebruiken.
We beginnen met een snelle, betrouwbare set basistests die de belangrijkste gebruikershandelingen controleert. Kan de applicatie starten? Kan een gebruiker inloggen? Worden toegangsrechten afgedwongen? Kan een representatieve transactie voltooid en correct teruggelezen worden? Kan een kritieke achtergrondtaak correct worden afgerond?
Deze controles moeten worden uitgevoerd op de versie die we daadwerkelijk willen uitrollen in een representatieve omgeving. "De homepage geeft HTTP 200 terug" is nuttig, maar het is niet voldoende bewijs dat een applicatie werkt.
Regressie- en integratietests maken bredere automatisering geloofwaardig
Voor betrouwbare onbeheerde updates raden we een bredere set controles aan:
- Regressietests: beschermen bestaande bedrijfsfunctionaliteit, inclusief berekeningen, validatie, toegangsrechten en eerder opgeloste defecten.
- Integratietests: verifiëren interacties met databases, queues, identity providers en externe API's, inclusief fouten, herhaalpogingen en time-outs.
- Beveiligings- en compatibiliteitscontroles: inspecteren dependencies en images, testen toegangsgrenzen en identificeren niet-ondersteunde combinaties.
Voor belangrijke integraties kunnen mocks alleen geen compatibiliteit met de echte service vaststellen. Combineer gecontroleerde testvervangers met contracttests of integratietests in een afgeschermde testomgeving waar beschikbaar. Gebruik geïsoleerde data en voorkom dat testactiviteit echte klantberichten verstuurt of echte transacties veroorzaakt.
De suite heeft ook onderhoud nodig. Onbetrouwbare tests, verouderde testgegevens en genegeerde fouten verzwakken releasebeslissingen. Bij HIT focussen we op betrouwbare dekking van essentiële functionaliteit, met duidelijke verantwoordelijkheid voor het oplossen van fouten. Als een vereiste controle faalt, stopt de pipeline.
Canary releases beperken hoe ver een probleem zich kan verspreiden
Zelfs een sterke testset kan niet elke productieconditie reproduceren. Een canary release stelt een beperkt deel van het echte verkeer bloot aan een nieuwe versie, evalueert het en gebruikt dat resultaat om te beslissen of de uitrol moet doorgaan. het SRE-handboek van Google beschrijft deze aanpak en het belang van het vergelijken van de canary met de ongewijzigde controlegroep. Referentie: Google SRE, Canarying Releases.
Voor een geschikte service zou HIT bijvoorbeeld een stapsgewijze uitrol van 1%, 5%, 25% en dan 100% van het verkeer kunnen configureren. Dit zijn startpunten voor discussie, geen universeel veilige drempels. Elke fase heeft representatief verkeer nodig, genoeg observaties en tijd om relevante fouten bloot te leggen, inclusief achtergrondtaken.
Een applicatie met weinig verkeer heeft mogelijk een langer observatievenster en synthetische controles nodig. Gedeelde databases, globale configuratie en onomkeerbare schrijfbewerkingen vereisen speciale zorg: een klein verkeerspercentage isoleert hun gevolgen niet automatisch.
Monitoring moet de uitrol kunnen wijzigen
Een dashboard dat iemand morgen misschien controleert doet weinig om een release die nu plaatsvindt te beschermen.
We koppelen beslissingen over de uitrol aan versiespecifieke signalen: mislukte verzoeken, responstijden, systeembelasting, wachtrijvertragingen en het succespercentage van belangrijke gebruikersprocessen. Vergelijk de kandidaat met de stabiele versie en met afgesproken servicedoelstellingen. Een algemeen gemiddelde kan een falende canary verbergen.
Als die signalen verslechteren buiten de afgesproken limieten, moet automatisering de verdere uitrol stoppen en, waar veilig, verkeer terugsturen naar de vorige versie. Ontbrekende of onvoldoende duidelijke meetgegevens moeten de verdere uitrol pauzeren in plaats van als succes tellen. Het verantwoordelijke team ontvangt een bruikbare melding en de informatie die nodig is voor onderzoek.
Rollback moet ontworpen en geoefend worden. Terugkeren naar een oudere applicatieversie maakt corrupte data niet ongedaan en draait een destructieve schema-migratie niet terug. Migraties die ook met de vorige applicatieversie werken, geteste back-ups en herstelprocedures blijven deel van het ontwerp.
Hoe HIT hierbij helpt
We helpen onderhoud om te zetten in een vast en herhaalbaar onderdeel van het beheer: componenten en eigenaarschap in kaart brengen, updateprioriteiten definiëren, de pipeline bouwen, zinvolle tests opzetten en gefaseerde releases koppelen aan monitoring en herstel.
We beginnen met de belangrijkste gebruikersprocessen en de updates die verantwoord geautomatiseerd kunnen worden. Daarna breiden we de dekking en automatisering uit naarmate het bewijs verbetert. Het resultaat wordt gemeten aan de hand van praktische resultaten: tijd om relevante kwetsbaarheden te verhelpen, tijd besteed aan routineonderhoud, mislukte wijzigingen en hersteltijd.
Meer kwetsbaarheidsaankondigingen maken manueel onderhoud moeilijker vol te houden. Geautomatiseerd LCM, betrouwbare tests, canary releases en responsieve monitoring werken samen om blootstelling te verminderen en de impact op productie te beperken. Ze kunnen geen nul incidenten beloven, maar ze geven teams een gecontroleerde manier om software actueel te houden.
HIT maakt continu onderhoud beheersbaar, zodat mensen hun aandacht kunnen richten op de uitzonderingen die hun vakkennis vragen.