Mehr Schwachstellen, weniger manuelle Wartung: Warum automatisierte Pipelines unverzichtbar sind
Steigende Schwachstellenvolumen machen automatisierte Lifecycle-Wartung unverzichtbar. HIT kombiniert aussagekräftige Tests, Canary-Releases und Monitoring, um das Produktionsrisiko zu reduzieren.
Ein Sicherheitsupdate für eine Bibliothek, die Ihre Anwendung nutzt, wird verfügbar. Das Einspielen kann in wenigen Minuten erledigt sein. Herauszufinden, ob es die Authentifizierung, einen Kunden-Workflow oder eine Integration beeinträchtigt, kann deutlich länger dauern.
Wenn jedes Update eine manuelle Untersuchung und einen sorgfältig koordinierten Release-Abend erfordert, wird Wartung zur Warteschlange. Je länger diese Warteschlange wird, desto länger können Systeme exponiert bleiben.
Bei HIT ist unsere Position klar: Automatisierte Pipelines sind heute unverzichtbar, um Produktionssoftware in einem nachhaltigen Tempo zu warten. Ihr Wert hängt von den Nachweisen ab, die sie liefern: aussagekräftige Tests vor dem Release, kontrollierte Exposition während des Rollouts und Monitoring, das eine fehlerhafte Änderung stoppen kann.
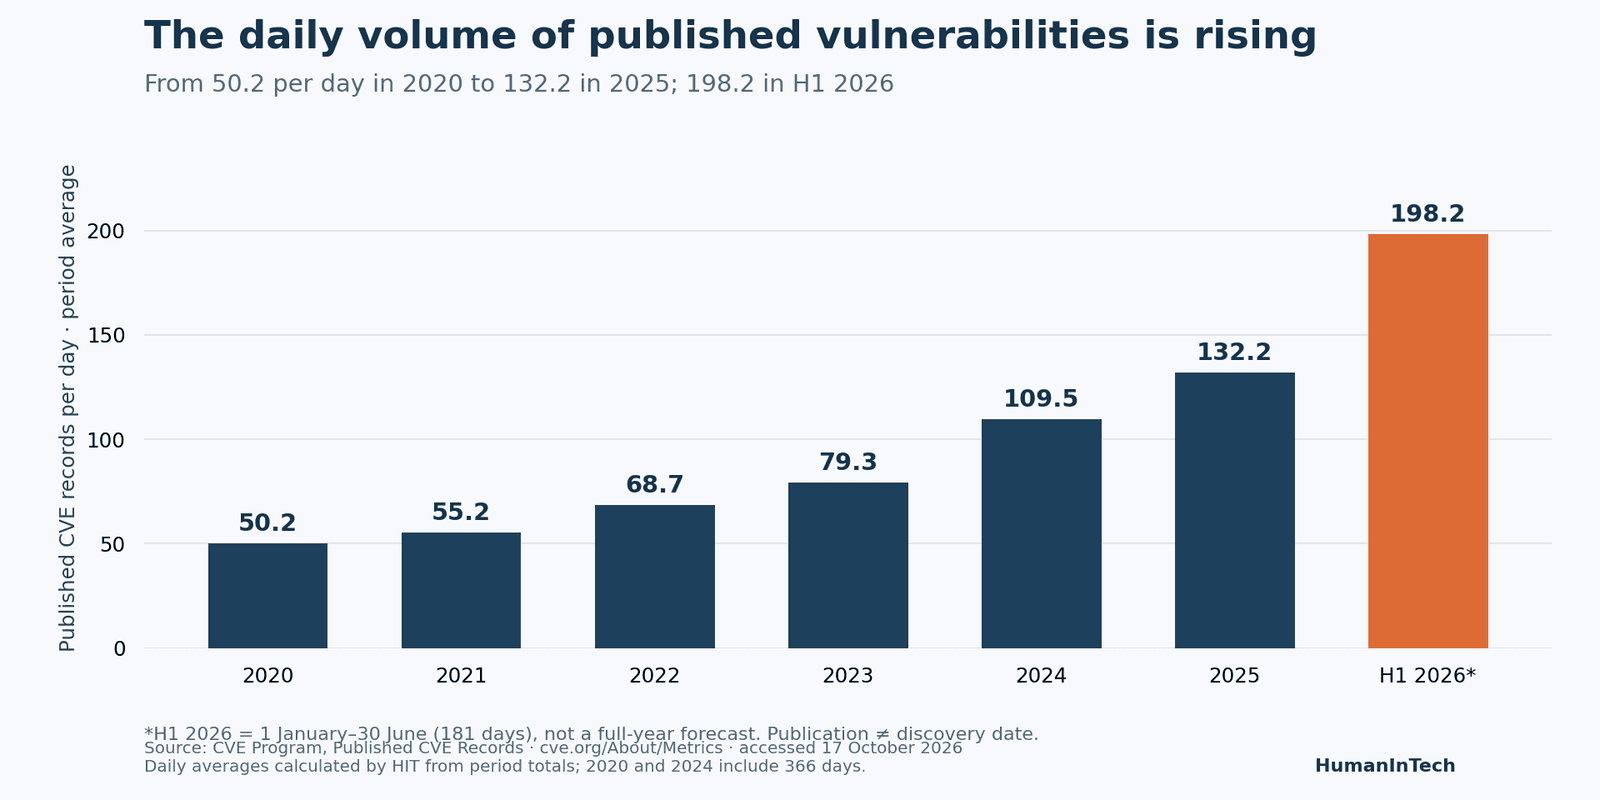
Von rund 50 veröffentlichten Schwachstellen pro Tag auf fast 200
Das CVE Program verzeichnete 2020 18.375 veröffentlichte CVE-Einträge: durchschnittlich 50,2 pro Tag. 2025 erreichte diese Zahl 48.244 oder 132,2 pro Tag. Für Januar bis Juni 2026 listet es 35.872 Einträge auf: 198,2 pro Tag über 181 Tage. Dies sind HIT-Berechnungen aus den offiziellen CVE-Veröffentlichungsstatistiken, abgerufen am 17. Oktober 2026.
Das Diagramm verwendet Periodensummen geteilt durch Kalendertage, unter Berücksichtigung von Schaltjahren. Der Balken für 2026 deckt nur das erste Halbjahr ab, es handelt sich nicht um eine Ganzjahresprognose. Die Quelle hatte Q3 zum Zeitpunkt der Prüfung noch nicht ausgefüllt.
Diese Zahlen zählen veröffentlichte Einträge, nicht an jedem Tag entdeckte Schwachstellen, Angriffe oder Fehler, die Ihre spezielle Anwendung betreffen. Änderungen in der Berichterstattung und bei Veröffentlichungspraktiken beeinflussen ebenfalls die Gesamtzahlen. Die praktische Implikation ist ein wachsendes Volumen zu bewertender Offenlegungen, nicht eine direkte Messung des Risikos Ihrer Organisation.
Lifecycle-Management benötigt einen wiederholbaren Weg in die Produktion
Lifecycle-Management oder LCM umfasst die Aktualisierung von Abhängigkeiten, Laufzeitumgebungen, Container-Images und Betriebssystemen auf unterstützte Versionen. Es bedeutet auch, Upgrades zu planen, bevor Komponenten das Ende des Supports erreichen.
Wir möchten, dass routinemäßige, gut verstandene Wartung einen nahezu automatisierten Prozess durchläuft. Eine geplante Prüfung identifiziert ein Update, schlägt eine kleine Änderung vor, erstellt einen versionierten Release und führt die erforderlichen Prüfungen durch. Geeignete Änderungen können dann gemäß einer vereinbarten Richtlinie fortschreiten. Upgrades mit inkompatiblen Änderungen, destruktive Migrationen und unsichere Ergebnisse gehen zur Überprüfung an eine Fachkraft.
Beispielsweise sollte ein Patch für eine HTTP-Bibliothek mehr als nur einen erfolgreichen Build auslösen. Die Pipeline sollte Login, ausgehende API-Aufrufe, Timeouts und Fehlerbehandlung überprüfen, bevor der Release fortschreiten darf.
Automatisierung sollte auch dabei helfen zu entscheiden, was zuerst Aufmerksamkeit benötigt. Wir empfehlen, Komponenteninventar, tatsächliche Exposition, Herstellerempfehlungen und Nachweise für Ausnutzung zu kombinieren. Das NIST-Update vom April 2026 veranschaulicht diesen Bedarf an Priorisierung: Die NVD priorisiert nun die Anreicherung ausgewählter CVEs, einschließlich derjenigen im Known Exploited Vulnerabilities-Katalog der CISA. Eine fehlende NVD-Analyse ist kein Beweis dafür, dass eine Schwachstelle harmlos ist. Quelle: NISTs Erläuterung seiner aktualisierten NVD-Operationen.
Sanity-Tests sind das Mindestfundament
Eine Pipeline, die erfolgreich baut, sagt uns, dass die Software gebaut werden kann. Sie sagt uns nicht, dass Kunden sie noch nutzen können.
Wir beginnen mit einer schnellen, zuverlässigen Sanity-Suite, die die wesentlichen Nutzerabläufe abdeckt. Kann die Anwendung starten? Kann sich ein Benutzer anmelden? Werden Berechtigungen durchgesetzt? Kann eine repräsentative Transaktion abgeschlossen und korrekt zurückgelesen werden? Kann ein kritischer Hintergrundjob abgeschlossen werden?
Diese Prüfungen sollten gegen den tatsächlichen Release-Kandidaten in einer repräsentativen Umgebung laufen. „Die Homepage gibt HTTP 200 zurück" ist nützlich, aber kein ausreichender Beweis dafür, dass eine Anwendung funktioniert.
Regressions- und Integrationstests machen umfassendere Automatisierung glaubwürdig
Für zuverlässige unbeaufsichtigte Updates empfehlen wir einen umfassenderen Satz von Prüfungen:
- Regressionstests: schützen bestehende Geschäftslogik, einschließlich Berechnungen, Validierung, Berechtigungen und zuvor behobener Fehler.
- Integrationstests: verifizieren Interaktionen mit Datenbanken, Queues, Identity-Providern und externen APIs, einschließlich Fehlern, Wiederholungen und Timeouts.
- Sicherheits- und Kompatibilitätsprüfungen: untersuchen Abhängigkeiten und Images, testen Zugriffsgrenzen und identifizieren nicht unterstützte Kombinationen.
Bei wichtigen Integrationen können Mocks allein die Kompatibilität mit dem echten Service nicht nachweisen. Kombinieren Sie kontrollierte Test-Doubles mit Contract-Checks oder Sandbox-Integrationstests, wo verfügbar. Verwenden Sie isolierte Daten und verhindern Sie, dass Testaktivitäten echte Kundennachrichten senden oder echte Transaktionen auslösen.
Die Suite benötigt ebenfalls Wartung. Flaky Tests, veraltete Fixtures und ignorierte Fehler schwächen Release-Entscheidungen. Bei HIT konzentrieren wir uns auf vertrauenswürdige Abdeckung kritischen Verhaltens mit klarer Verantwortung für Fehler. Wenn eine erforderliche Prüfung fehlschlägt, stoppt die Pipeline.
Canary-Releases begrenzen, wie weit sich ein Problem ausbreiten kann
Selbst eine starke Test-Suite kann nicht jede Produktionsbedingung reproduzieren. Ein Canary-Release exponiert einen begrenzten Teil des echten Traffics gegenüber einer neuen Version, bewertet ihn und nutzt dieses Ergebnis, um zu entscheiden, ob der Rollout fortgesetzt werden soll. Googles SRE-Workbook beschreibt diesen Ansatz und die Bedeutung des Vergleichs des Canary mit der unveränderten Kontrollgruppe. Referenz: Google SRE, Canarying Releases.
Für einen geeigneten Service könnte HIT eine beispielhafte schrittweise Ausweitung von 1%, 5%, 25% und dann 100% des Traffics konfigurieren. Dies sind Ausgangspunkte für Diskussionen, keine universellen sicheren Schwellenwerte. Jede Stufe benötigt repräsentativen Traffic, genügend Beobachtungen und Zeit, um relevante Fehler aufzudecken, einschließlich Hintergrundprozessen.
Eine Anwendung mit geringem Volumen benötigt möglicherweise ein längeres Beobachtungsfenster und synthetische Prüfungen. Gemeinsam genutzte Datenbanken, globale Konfiguration und irreversible Schreibvorgänge erfordern besondere Sorgfalt: Ein kleiner Traffic-Prozentsatz isoliert ihre Konsequenzen nicht automatisch.
Monitoring muss in der Lage sein, den Rollout zu ändern
Ein Dashboard, das jemand morgen vielleicht prüft, trägt wenig zum Schutz eines Releases bei, das jetzt stattfindet.
Wir verbinden Rollout-Entscheidungen mit versionsspezifischen Signalen: fehlgeschlagene Anfragen, Latenz, Ressourcendruck, Queue-Verzögerungen und die Erfolgsrate wichtiger Geschäftsprozesse. Vergleichen Sie den Kandidaten mit der stabilen Version und mit vereinbarten Service-Zielen. Ein Gesamtdurchschnitt kann einen fehlschlagenden Canary verbergen.
Wenn sich diese Signale über die vereinbarten Grenzen hinaus verschlechtern, sollte die Automatisierung die weitere Ausrollung stoppen und, wo sicher, den Traffic zur vorherigen Version zurückführen. Fehlende oder nicht schlüssige Telemetrie sollte den Fortschritt pausieren, anstatt als Erfolg zu zählen. Das verantwortliche Team erhält eine Warnung mit konkretem Handlungsbedarf und die für die Untersuchung benötigten Nachweise.
Rollback muss geplant und geübt werden. Die Rückkehr zu einer älteren Anwendungsversion macht beschädigte Daten nicht rückgängig und kehrt eine destruktive Schema-Migration nicht um. Rückwärtskompatible Migrationen, getestete Backups und Wiederherstellungsverfahren bleiben Teil des Designs.
Was HIT zum Prozess beiträgt
Wir helfen dabei, Wartung in eine wiederholbare operative Fähigkeit zu verwandeln: Komponenten und Verantwortlichkeiten abbilden, Update-Prioritäten definieren, die Pipeline aufbauen, aussagekräftige Tests etablieren und gestaffelte Releases mit Monitoring und Recovery verbinden.
Wir beginnen mit den wichtigsten Nutzerabläufe und den Updates, die verantwortungsvoll automatisiert werden können. Dann erweitern wir Abdeckung und Automatisierung, sobald sich die Evidenz verbessert. Das Ergebnis wird anhand praktischer Resultate gemessen: Zeit zur Behebung relevanter Schwachstellen, Zeitaufwand für Routinewartung, fehlgeschlagene Änderungen und Wiederherstellungszeit.
Mehr Schwachstellenveröffentlichungen machen manuelle Wartung schwerer aufrechtzuerhalten. Automatisiertes LCM, vertrauenswürdige Tests, Canary Releases und responsives Monitoring arbeiten zusammen, um Exposition zu reduzieren und Produktionsauswirkungen zu begrenzen. Sie können keinen vollständig störungsfreien Betrieb garantieren, aber sie geben Teams eine kontrollierte Möglichkeit, Software aktuell zu halten.
Bei HIT schaffen wir das Vertrauen, Software kontinuierlich zu warten, wobei sich die Mitarbeiter auf die Ausnahmen konzentrieren, die ihr Urteilsvermögen erfordern.