Plus de vulnérabilités, moins de maintenance manuelle : pourquoi les pipelines automatisés sont essentiels
L'augmentation du volume de vulnérabilités rend la maintenance automatisée du cycle de vie essentielle. HIT combine des tests significatifs, des déploiements canary et une surveillance pour réduire les risques en production.
Une mise à jour de sécurité devient disponible pour une bibliothèque utilisée par votre application. L'appliquer peut prendre quelques minutes. Découvrir si elle casse l'authentification, un workflow client ou une intégration peut prendre beaucoup plus de temps.
Lorsque chaque mise à jour nécessite une investigation manuelle et une soirée de déploiement soigneusement coordonnée, la maintenance devient une file d'attente. Plus cette file s'allonge, plus les systèmes peuvent rester exposés longtemps.
Chez HIT, notre position est claire : les pipelines automatisés sont désormais essentiels pour maintenir les logiciels en production à un rythme soutenable. Leur valeur dépend des preuves qu'ils produisent : des tests significatifs avant le déploiement, une exposition contrôlée pendant le déploiement et une surveillance capable d'arrêter un changement problématique.
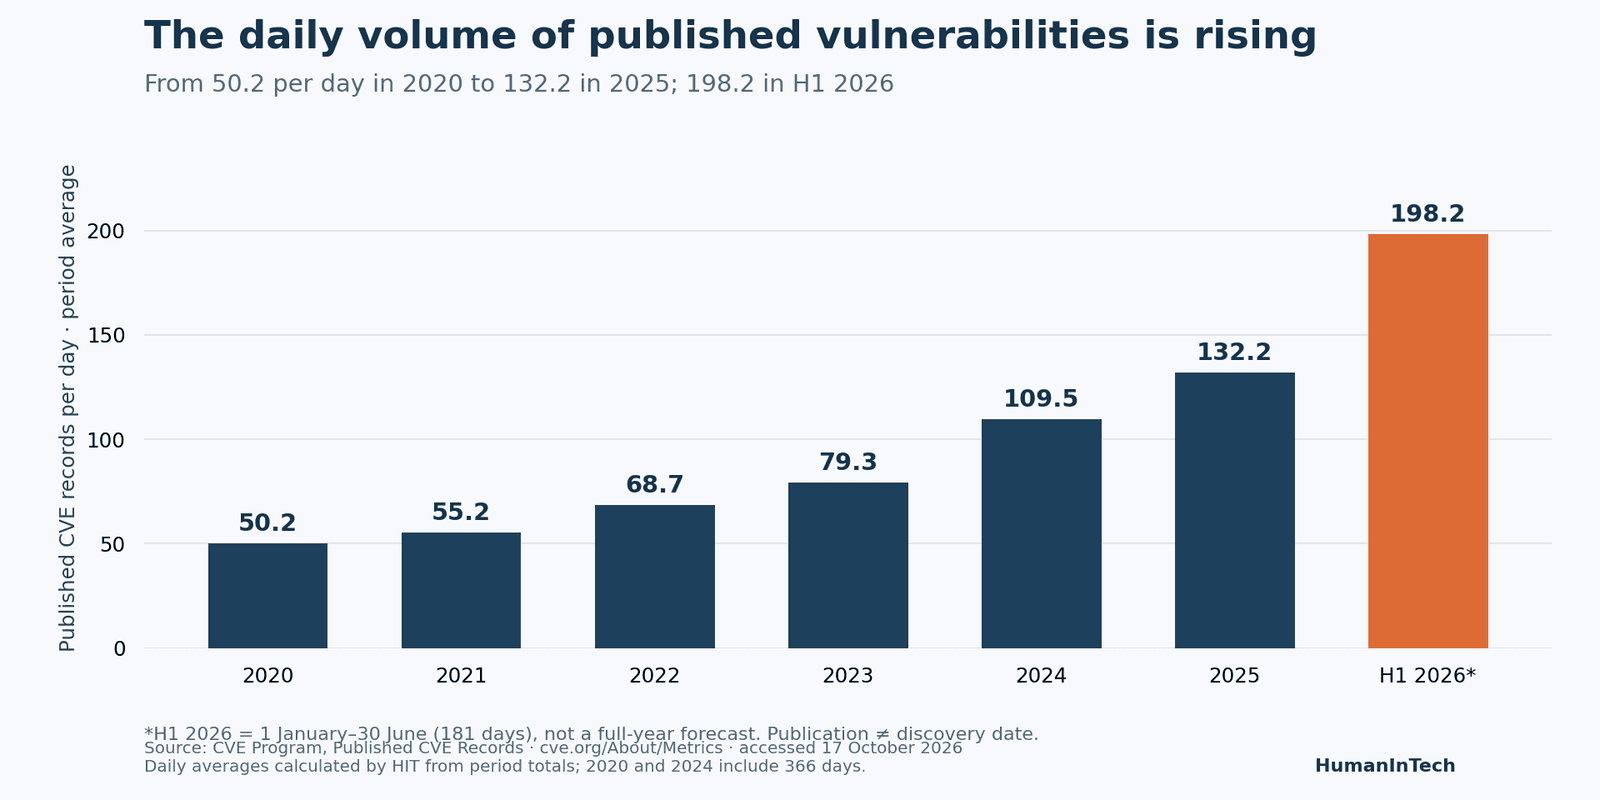
D'environ 50 vulnérabilités publiées par jour à près de 200
Le CVE Program a enregistré 18 375 enregistrements CVE publiés en 2020 : une moyenne de 50,2 par jour. En 2025, ce chiffre a atteint 48 244, soit 132,2 par jour. Pour janvier–juin 2026, il liste 35 872 enregistrements : 198,2 par jour sur 181 jours. Il s'agit de calculs HIT basés sur les statistiques officielles de publication CVE, consultées le 17 octobre 2026.
Le graphique utilise les totaux par période divisés par les jours calendaires, années bissextiles comprises. La barre 2026 ne couvre que le premier semestre de l'année, ce n'est pas une prévision annuelle complète. La source n'avait pas encore renseigné le T3 lors de la consultation.
Ces chiffres comptent les enregistrements publiés, pas les vulnérabilités découvertes chaque jour, les attaques ou les failles affectant votre application particulière. Les changements dans la couverture des rapports et les pratiques de publication influencent également les totaux. L'implication pratique est un volume croissant de divulgations à évaluer, plutôt qu'une mesure directe du risque de votre organisation.
La gestion du cycle de vie nécessite un chemin reproductible vers la production
La gestion du cycle de vie, ou LCM, comprend le maintien des dépendances, des runtimes, des images de conteneurs et des systèmes d'exploitation sur des versions supportées. Cela signifie également planifier les mises à niveau avant que les composants n'atteignent leur fin de support.
Nous voulons que la maintenance routinière et bien comprise passe par un processus presque automatisé. Une vérification planifiée identifie une mise à jour, propose un petit changement, construit un livrable identifié par un numéro de version et exécute les vérifications requises. Les changements éligibles peuvent ensuite progresser selon une politique convenue. Les mises à niveau comportant des incompatibilités, les migrations destructives et les résultats incertains sont transmis à un ingénieur pour examen.
Par exemple, un correctif pour une bibliothèque HTTP devrait déclencher plus qu'une compilation réussie. Le pipeline devrait vérifier la connexion, les appels API sortants, les timeouts et la gestion des erreurs avant d'autoriser la progression du déploiement.
L'automatisation devrait également aider à décider ce qui nécessite une attention en premier. Nous recommandons de combiner l'inventaire des composants, l'exposition réelle, les recommandations du fournisseur et les preuves d'exploitation. La mise à jour d'avril 2026 du NIST illustre ce besoin de priorisation : le NVD priorise désormais l'enrichissement de CVE sélectionnés, y compris ceux du catalogue Known Exploited Vulnerabilities de la CISA. L'absence d'analyse NVD n'est pas une preuve qu'une vulnérabilité est inoffensive. Source : explication du NIST sur ses opérations NVD mises à jour.
Les tests de bon fonctionnement constituent le minimum
Un pipeline qui compile avec succès nous indique que le logiciel peut être compilé. Il ne nous dit pas que les clients peuvent toujours l'utiliser.
Nous commençons par une série rapide et fiable de tests de bon fonctionnement couvrant les parcours essentiels. L'application peut-elle démarrer ? Un utilisateur peut-il se connecter ? Les permissions sont-elles appliquées ? Une transaction représentative peut-elle être complétée et relue correctement ? Un job en arrière-plan critique peut-il se terminer ?
Ces vérifications doivent s'exécuter sur la version effectivement destinée au déploiement dans un environnement représentatif. « La page d'accueil renvoie HTTP 200 » est utile, mais ce n'est pas une preuve suffisante qu'une application fonctionne.
Les tests de régression et d'intégration rendent l'automatisation plus large crédible
Pour des mises à jour automatiques fiables, nous recommandons un ensemble plus large de vérifications :
- Tests de régression : protègent le comportement métier existant, y compris les calculs, la validation, les permissions et les défauts précédemment corrigés.
- Tests d'intégration : vérifient les interactions avec les bases de données, les files d'attente, les fournisseurs d'identité et les API externes, y compris les échecs, les nouvelles tentatives et les timeouts.
- Vérifications de sécurité et de compatibilité : inspectent les dépendances et les images, testent les limites d'accès et identifient les combinaisons non supportées.
Pour les intégrations importantes, les mocks seuls ne peuvent pas établir la compatibilité avec le service réel. Combinez des doublures de test contrôlées avec des vérifications de contrat ou des tests d'intégration sandbox lorsque disponibles. Utilisez des données isolées et empêchez l'activité de test d'envoyer de vrais messages clients ou de déclencher de vraies transactions.
La suite nécessite également de la maintenance. Les tests instables, les fixtures obsolètes et les échecs ignorés affaiblissent les décisions de déploiement. Chez HIT, nous nous concentrons sur une couverture fiable du comportement critique, avec des responsabilités claires pour résoudre les échecs. Si une vérification requise échoue, le pipeline s'arrête.
Les déploiements canary limitent la propagation d'un problème
Même une suite de tests solide ne peut pas reproduire toutes les conditions de production. Un déploiement canary expose une portion limitée du trafic réel à une nouvelle version, l'évalue et utilise ce résultat pour décider si le déploiement doit continuer. Le workbook SRE de Google décrit cette approche et l'importance de comparer le canary avec le groupe de contrôle inchangé. Référence : Google SRE, Canarying Releases.
Pour un service approprié, HIT pourrait configurer une progression illustrative de 1 %, 5 %, 25 % puis 100 % du trafic. Ce sont des points de départ pour la discussion, pas des seuils de sécurité universels. Chaque étape nécessite un trafic représentatif, suffisamment d'observations et de temps pour exposer les échecs pertinents, y compris le travail en arrière-plan.
Une application à faible volume peut nécessiter une fenêtre d'observation plus longue et des vérifications synthétiques. Les bases de données partagées, la configuration globale et les écritures irréversibles nécessitent une attention particulière : un faible pourcentage de trafic n'isole pas automatiquement leurs conséquences.
La surveillance doit pouvoir modifier le déploiement
Un tableau de bord que quelqu'un pourrait consulter demain fait peu pour protéger un déploiement en cours maintenant.
Nous connectons les décisions de déploiement à des signaux spécifiques à la version : requêtes échouées, latence, pression sur les ressources, délais de file d'attente et taux de réussite des parcours métier importants. Comparez le candidat avec la version stable et avec les objectifs de service convenus. Une moyenne globale peut masquer un canary défaillant.
Si ces signaux se détériorent au-delà des limites convenues, l'automatisation devrait arrêter la promotion et, lorsque c'est sûr, renvoyer le trafic vers la version précédente. Une télémétrie manquante ou non concluante devrait mettre en pause la progression plutôt que de compter comme un succès. L'équipe responsable reçoit une alerte exploitable et les preuves nécessaires pour enquêter.
Le rollback doit être conçu et répété. Revenir à une version antérieure de l'application n'annule pas les données corrompues ni n'inverse une migration de schéma destructive. Les migrations rétrocompatibles, les sauvegardes testées et les procédures de récupération restent partie intégrante de la conception.
Ce que HIT apporte au processus
Nous aidons à transformer la maintenance en une capacité opérationnelle reproductible : recenser les composants et leurs responsables, définir les priorités de mise à jour, construire le pipeline, établir des tests pertinents et connecter les déploiements progressifs à la surveillance et à la récupération.
Nous commençons par les parcours applicatifs les plus importants et les mises à jour qui peuvent être automatisées de manière responsable. Nous élargissons ensuite la couverture et l'automatisation au fur et à mesure que les preuves s'améliorent. Les progrès se mesurent à des indicateurs concrets : temps de remédiation des vulnérabilités pertinentes, temps consacré à la maintenance de routine, changements échoués et temps de récupération.
L'augmentation des divulgations de vulnérabilités rend la maintenance manuelle plus difficile à assurer. Le LCM automatisé, les tests fiables, les déploiements canary et la surveillance réactive fonctionnent ensemble pour réduire l'exposition et limiter l'impact en production. Ils ne peuvent pas promettre zéro incident, mais ils offrent aux équipes un moyen contrôlé de maintenir les logiciels à jour.
Chez HIT, nous construisons la confiance nécessaire pour maintenir les logiciels en continu, avec des personnes concentrées sur les exceptions qui nécessitent leur jugement.